一起动脑筋 · 先看一个小故事
十张卡片怎么找都很快,一百万张时,检查方法的区别就明显了。
把过程摊开来看
- 顺序找可能看一百万张
- 有序折半每次去掉约一半
- 比较数关键操作,而非只看代码长度
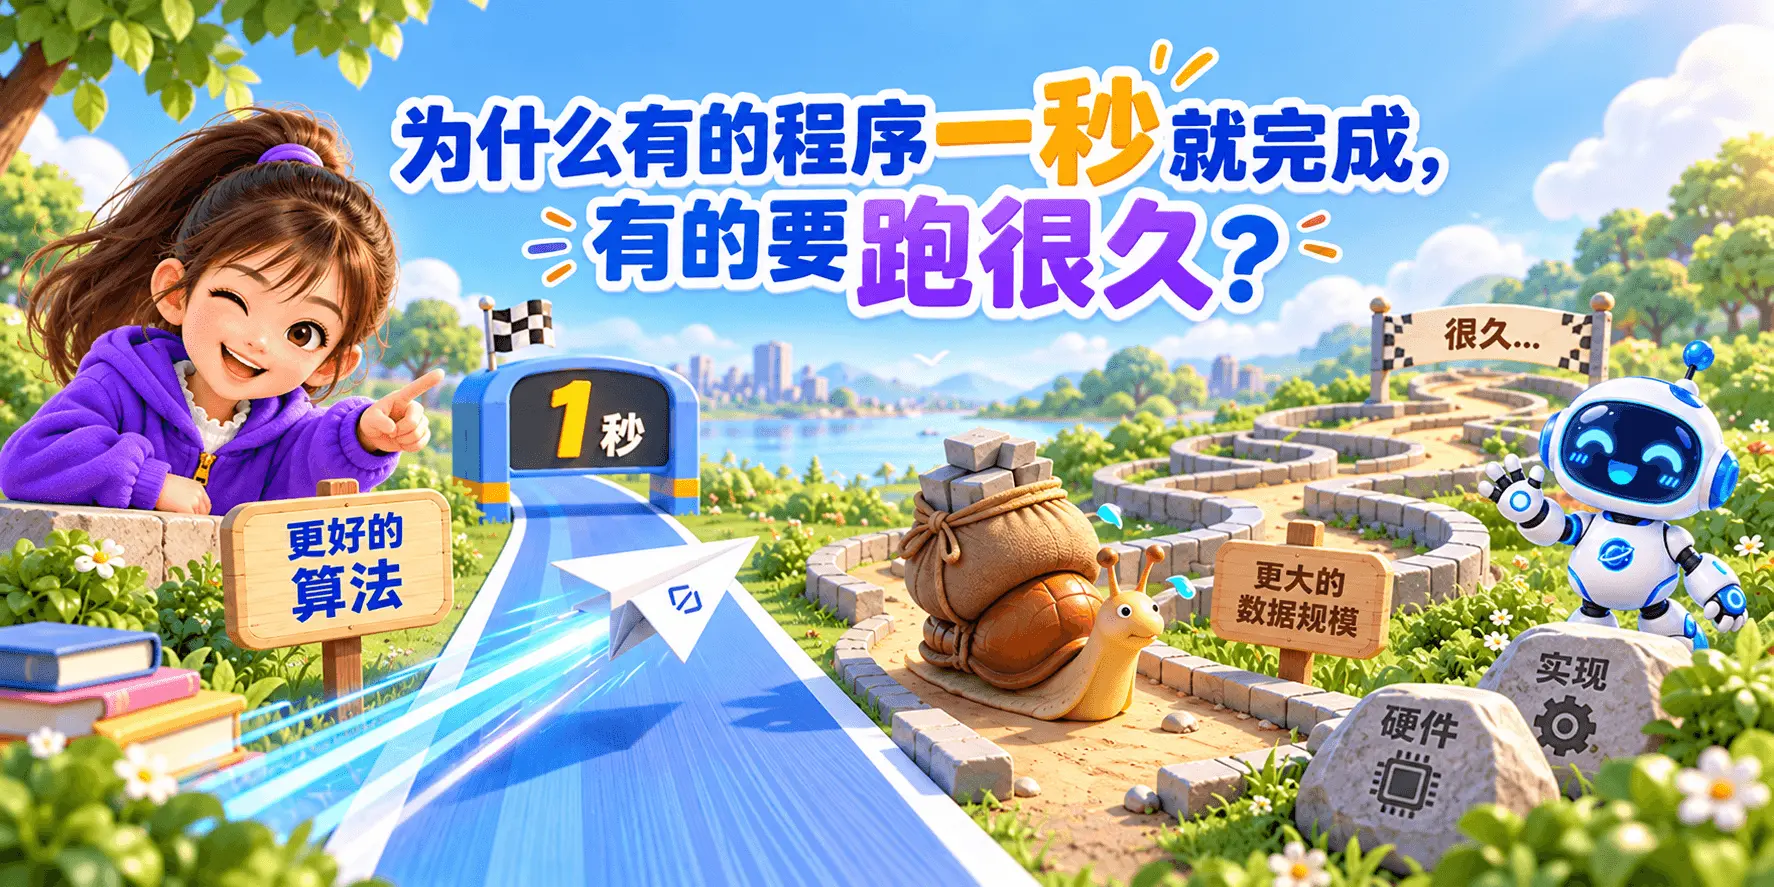
程序耗时受算法、数据规模、实现和硬件共同影响。
先数最关键的重复操作,能看出输入变大后工作量怎样增长。短代码也可能做非常多次工作。
01同一台电脑,为什么程序速度差很多?
因为程序做的“工作量”不同。
例如找一个数:
- 顺序查找可能看很多元素
- 二分查找每次排除一半
02电脑更快能解决所有问题吗?
不能。
如果算法工作量从 n 增加到 n²、2^n,输入变大时增长速度可能远远超过硬件提升。
03看一个简单对比
| n | n | n² | 2^n |
|---|---|---|---|
| 10 | 10 | 100 | 1024 |
| 20 | 20 | 400 | 1,048,576 |
| 30 | 30 | 900 | 约 10.7 亿 |
04是不是每一行代码都算一次操作?
不是。复杂度分析不会机械按“源代码行数”计算。
我们更关心关键操作随着输入规模增长的数量级。
05实际运行时间还受什么影响?
硬件
CPU、内存、缓存。
编译优化
编译器可能优化代码。
输入数据
不同输入可能走不同路径。
I/O
大量读写也可能成为瓶颈。
06为什么还要学复杂度?
因为复杂度帮助我们忽略机器细节,先判断:
输入变大时,算法工作量增长得有多快?
你已经知道了什么
- 程序速度和算法工作量密切相关。
- 更快硬件不能弥补所有糟糕算法。
- 复杂度关注工作量随输入规模的增长趋势。
- 源代码行数不等于算法操作数。
- 真实运行时间还受硬件、I/O 和优化等因素影响。
下一篇:什么是时间复杂度?
轮到你来试一试
只有一行代码的循环,重复十亿次,会因为代码短就很快吗?
想好了吗?点开看解释
不会。代码长度不是执行次数,必须看实际重复多少次和每次做什么。