一起动脑筋 · 先看一个小故事
女孩把一张照片和一个问题一起交给机器人:“哪只杯子在左边?”模型需要同时处理不同类型信息。
把过程摊开来看
- 图像提供视觉内容
- 文字说明问题
- 联合处理联系两种表示
- 输出给出回答
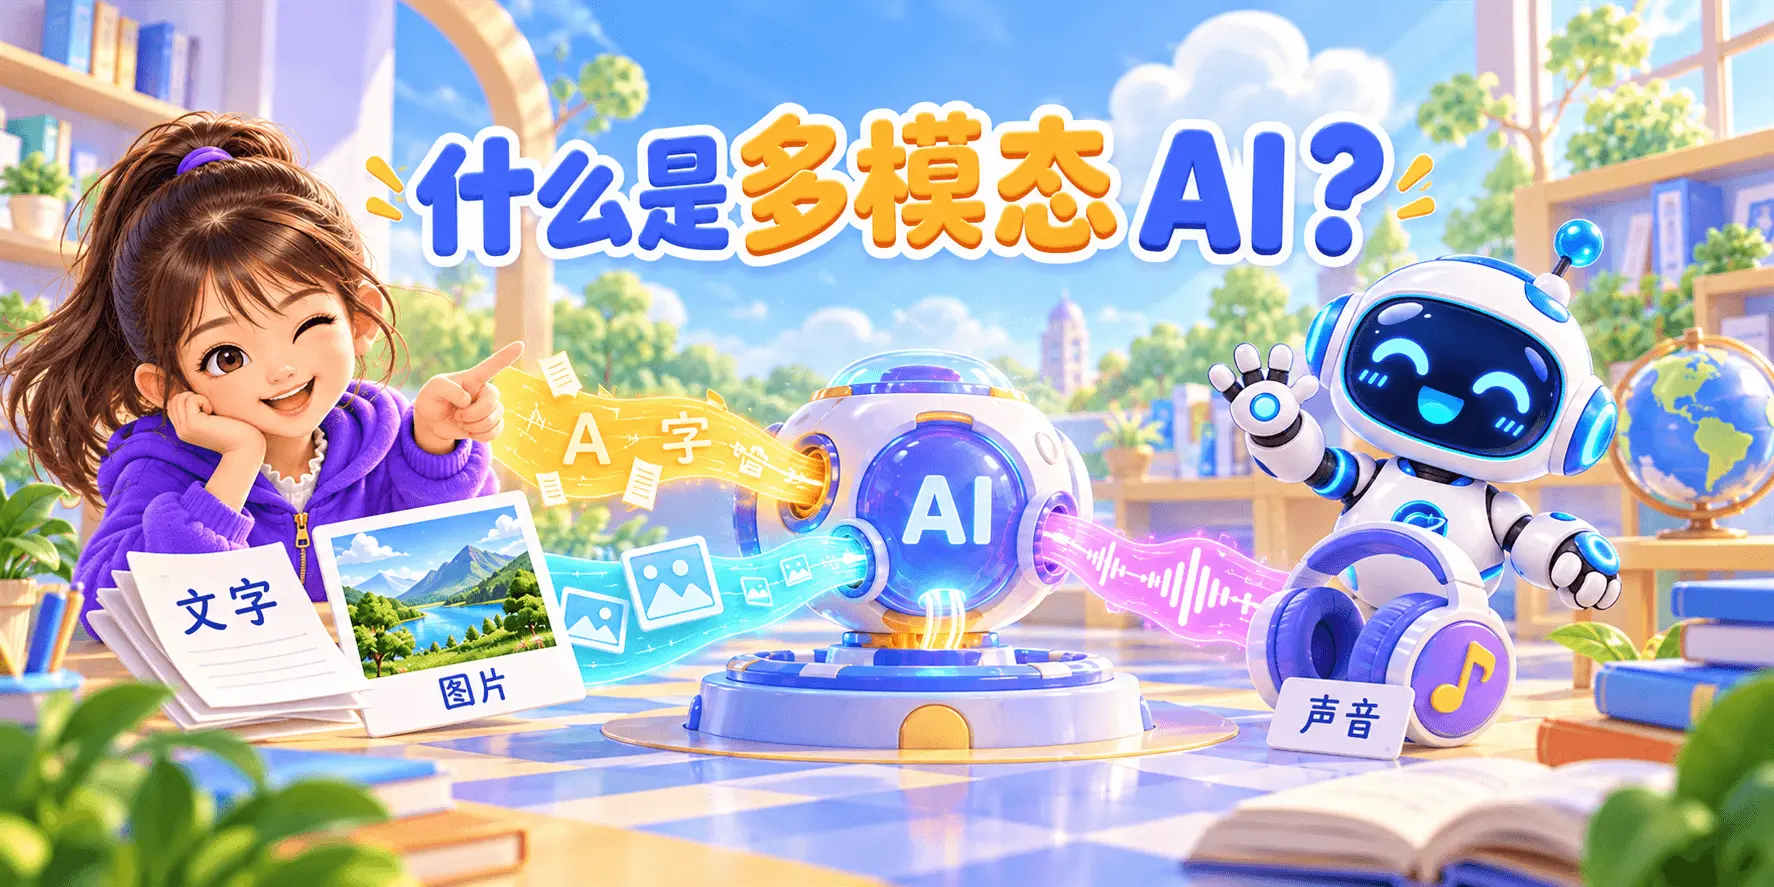
多模态 AI 处理或关联文字、图片、声音等多种数据形式。
“模态”可以先理解为信息的不同形式。图片说明场景,文字说明要找什么,结合后才能更好地完成任务。
系统支持哪些输入和输出取决于设计,不是贴上多模态标签就样样都能做。
轮到你来试一试
给一张模糊照片,要求读出很小的门牌号,模型应随便补全吗?
想好了吗?点开看解释
不应。应说明看不清,并请求更清楚的非敏感资料或采用其他核对方式。
带走一个发现
多模态 AI 处理或关联文字、图片、声音等多种数据形式。
试着遮住上面的图,把每一步讲给家人听。如果某一步说不清楚,就回到那张卡片再看一遍。