一起动脑筋 · 先看一个小故事
机器人每次算前三天页数,都重新加第一天和第二天。女孩把“前两天共多少”写在旁边。
把过程摊开来看
- 第一次2 加 3 得 5
- 保存前两天为 5
- 新增一天5 加 4 得 9
- 复用不用从头重算
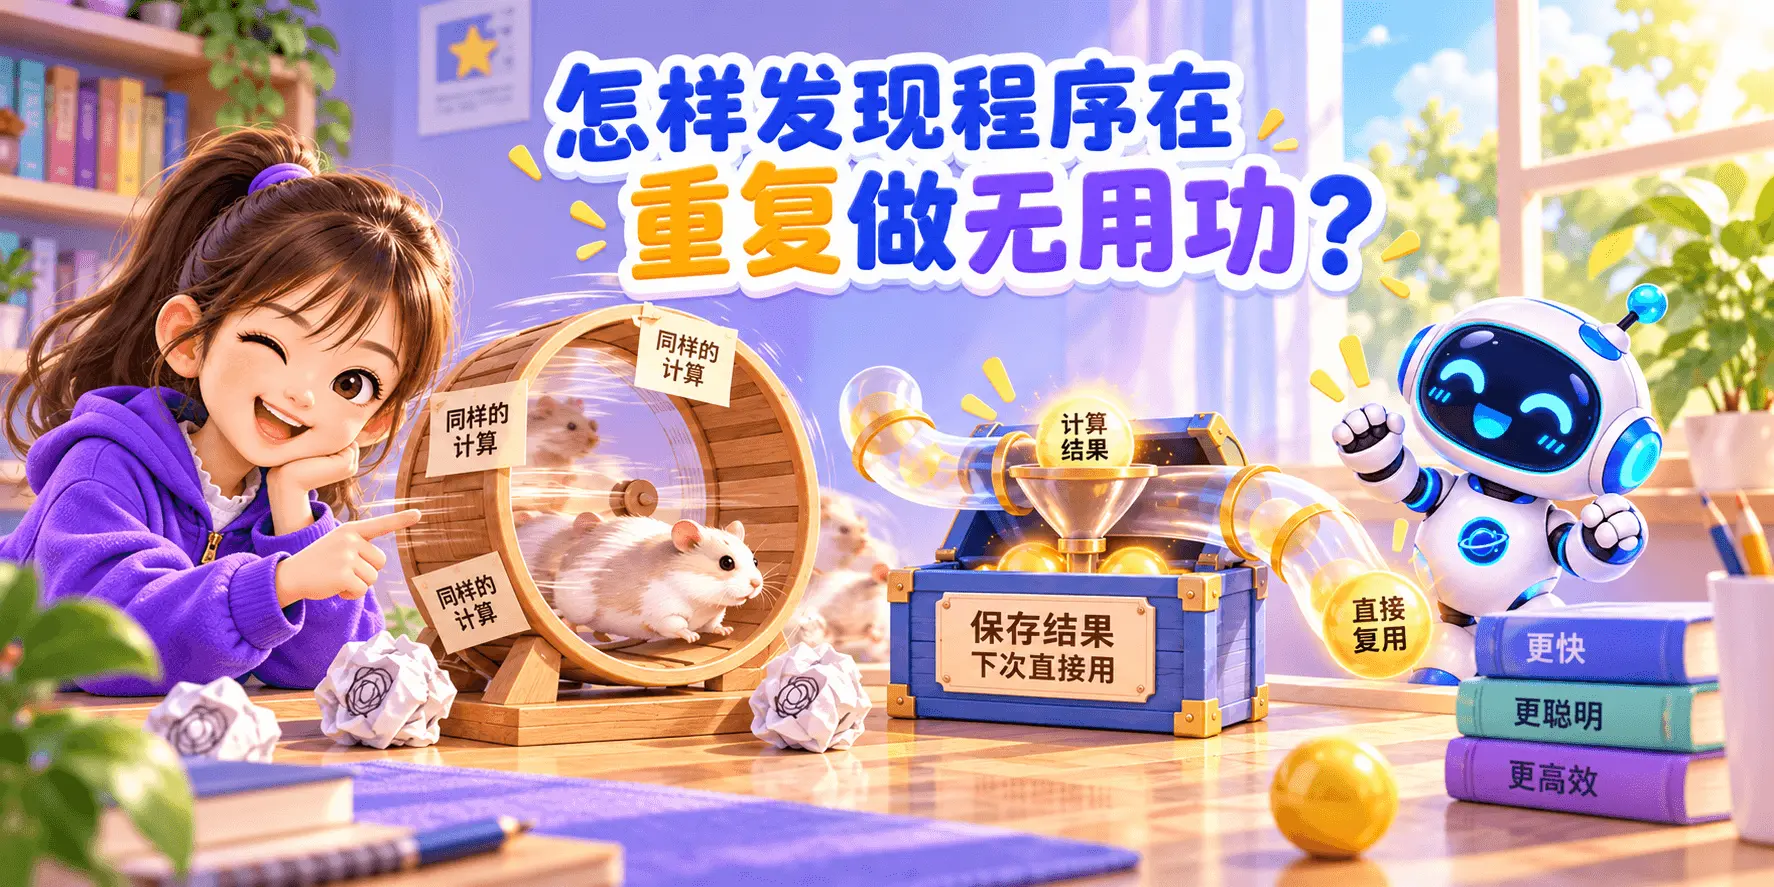
发现重复子任务后,可以考虑保存可复用结果。
关键是确认“同一任务”具有相同输入,且结果不会因为外部状态改变而失效。
01什么叫重复工作?
程序多次计算本来已经知道、或者可以提前保存的结果。
例如大量区间和查询,每次都从头重新加,就会反复计算相同前缀。
02怎样看见重复?
把几次计算过程写出来:
查询 1:加 a1+a2+a3+a4;查询 2:又加 a1+a2+a3
你会发现前面的部分反复出现。
03前缀和怎样消除重复?
提前保存:
prefix[i] = a[1] + ... + a[i]以后区间和只需要两个前缀值相减。
04递归中也会重复吗?
会。例如朴素 Fibonacci:
fib(5)
├─ fib(4)
│  └─ fib(3)
└─ fib(3)
fib(3) 会被算很多次。
以后可以用记忆化保存已经计算过的子问题结果。
05重复工作一定能消除吗?
不一定全部都能,也不一定值得。
保存结果需要额外内存和管理成本,因此要看重复程度和数据规模。
06还可以从哪里找重复?
循环
是否每轮都算相同表达式?
查询
是否反复扫描同一段数据?
搜索
是否多次进入相同状态?
你已经知道了什么
- 重复工作是慢程序的重要来源之一。
- 手工展开计算可以帮助发现重复。
- 前缀和、缓存、记忆化都能减少某些重复计算。
- 保存结果也有空间成本。
- 优化前要先确认哪里真的重复。
下一篇:怎样选择合适的数据结构和算法?
轮到你来试一试
第一天页数从 2 改成 6,原来保存的前两天总数 5 还能直接用吗?
想好了吗?点开看解释
不能,相关数据变了,累计结果也要更新。