一起动脑筋 · 先看一个小故事
女孩把“还没做完”的任务卡叠起来:最上面是机器人当前正在处理的任务。
把过程摊开来看
- main 等待放好返回位置
- A 等待A 又调用 B
- B 完成移走 B 的卡
- A 继续再回到 main
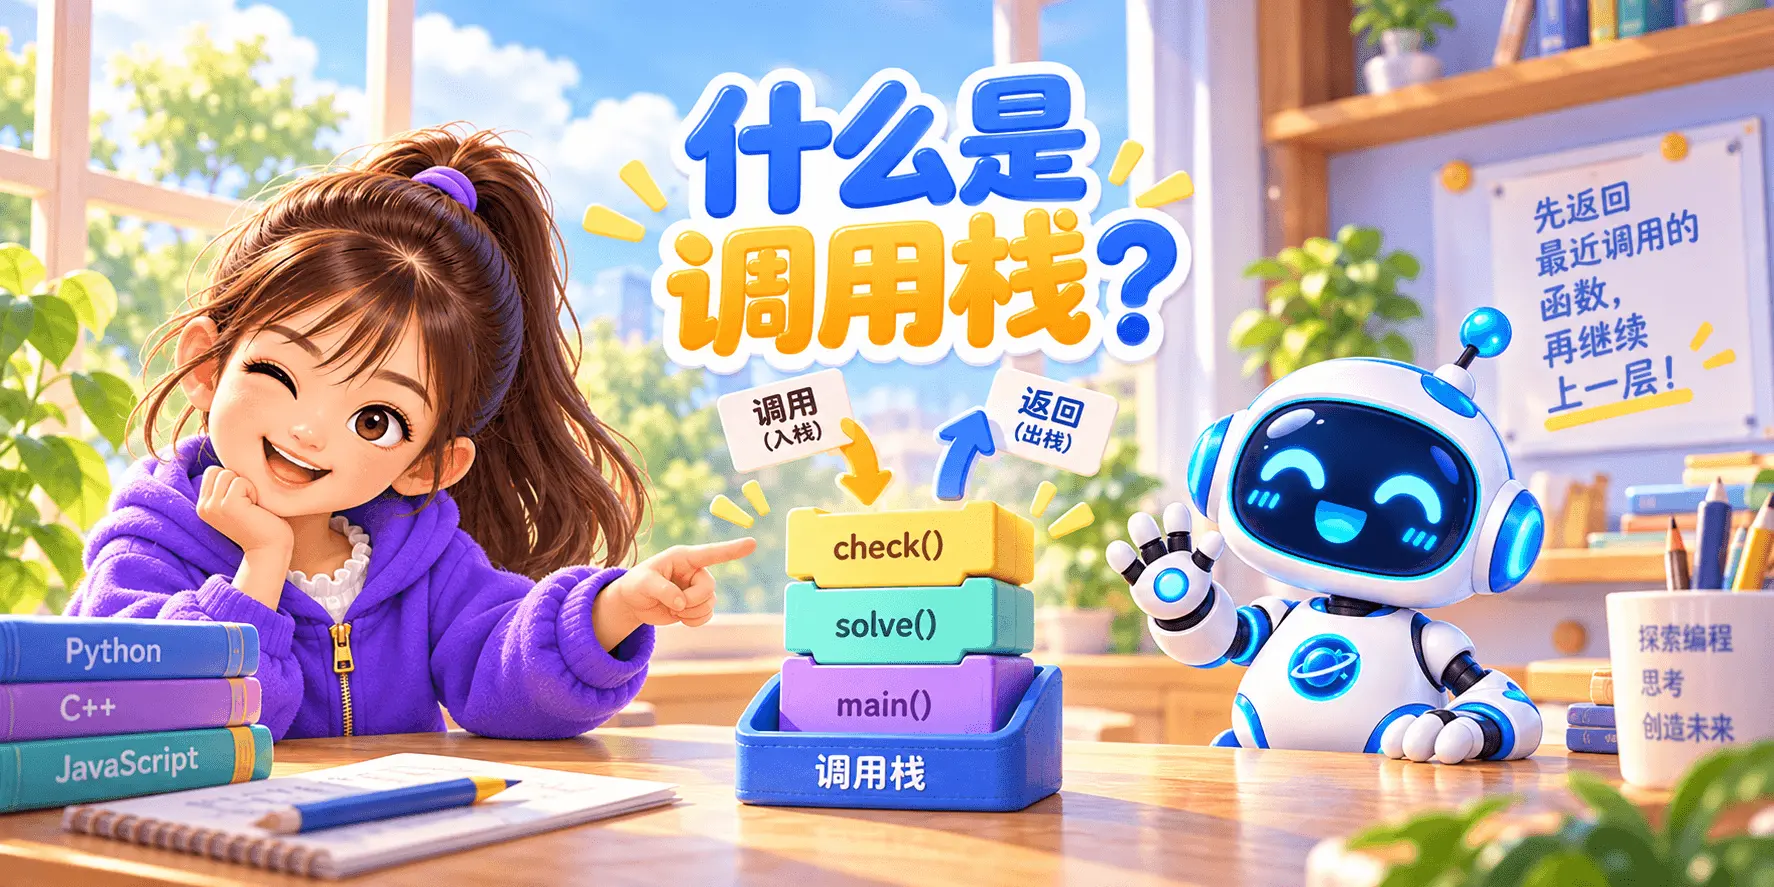
调用栈帮助管理普通函数调用的返回顺序。
最后进入的调用先完成并返回,像从最上面取任务卡。卡片里还可记录本次调用需要保留的信息。
看见调用,也看见返回
任务卡从左到右表示从栈底到栈顶。最右边是当前正在执行的一层。
f(3)
这一层要算 3 × f(2),先等待 f(2)。
f(3) 等待f(2)
这一层要算 2 × f(1),再新增一层。
f(3) 等待f(2) 等待f(1) 等待f(0) = 1
f(0) 直接返回 1,不再新增调用。
f(3) 等待f(2) 等待f(1) = 1
计算 1 × 1,得到 1 并返回。
f(3) 等待f(2) = 2
计算 2 × 1,得到 2 并返回。
f(3) = 6
计算 3 × 2,得到 6。本次调用完成。
01为什么需要记住“谁调用了谁”?
如果 main 调用 A,而 A 又调用 B,程序必须记住:
- B 完成后回到 A 的哪里
- A 完成后回到 main 的哪里
02调用栈可以怎样理解?
可以先把它想成一摞盘子:后放上去的盘子,要先拿下来。
B()A()main()
这种后进先出(LIFO)的关系非常适合表示嵌套函数调用。
03一次调用会放进什么?
常见实现会为一次活跃函数调用维护一个栈帧(stack frame)或类似调用状态,其中可能包含:
返回信息
函数结束后去哪里继续。
局部数据
某些局部变量。
保存的寄存器
恢复调用者运行状态。
参数相关数据
取决于调用约定。
04调用 A 再调用 B 时怎样变化?
第 1 步
→main
第 2 步
→A
main
第 3 步
B
A
main
B 返回后先移除 B 的调用状态,再回到 A;A 返回后再回到 main。
05为什么叫“栈”?
因为活跃调用的加入和返回顺序通常符合:
最后调用的函数,最先返回
这正是栈这种数据结构的核心特征。
06C++ 标准规定一定有这种物理栈吗?
没有规定每个函数都必须以某个固定的“物理栈帧”布局实现。
编译器可能内联函数,也可能对局部数据和寄存器进行优化。
07调用层数太深会怎样?
如果活跃调用不断增加,需要的运行时调用状态也会增加。
在实际系统中,调用栈空间是有限的,过深调用可能导致栈溢出(stack overflow)。
下一专题学习递归时,这一点会非常重要。
你已经知道了什么
- 调用栈帮助程序记录嵌套函数调用关系。
- 后调用的函数通常先返回,符合后进先出。
- 常见实现会为活跃调用维护栈帧或等价状态。
- 栈帧可能包含返回信息、局部数据和寄存器等。
- 具体栈帧布局不是 C++ 标准固定规定的。
- 调用层数过深可能耗尽实际调用栈空间。
下一篇:怎样把大问题拆成几个函数?
轮到你来试一试
main 调 A,A 调 B;B 结束后,先回 main 还是 A?
想好了吗?点开看解释
先回 A。A 完成后才回 main,这就是后进入的调用先返回。