01CPU 执行的到底是什么?
我们写程序时,可能看到的是 C++、Python 或其他高级语言。 但 CPU 最终执行的不是这些文字,而是机器指令(Machine Instruction)。
每条机器指令都会告诉处理器做一种比较明确的事情, 例如:读取数据、相加、比较、跳转、把结果写回某个位置。
计算
加、减、位运算等
搬运数据
在寄存器和内存之间移动数据
比较
判断两个值的关系
跳转
决定下一步去执行哪里
02CPU 怎样知道下一条指令在哪里?
CPU 内部会保存“接下来应该从哪里取指令”的信息。 这个位置通常由一个特殊寄存器表示,常叫 程序计数器(Program Counter,PC); 在不同处理器架构里,它也可能有不同名字。
程序中的机器指令
指令 A指令 B指令 C指令 D程序计数器 PC
104指向下一条要取的指令位置
03取指、译码、执行是什么意思?
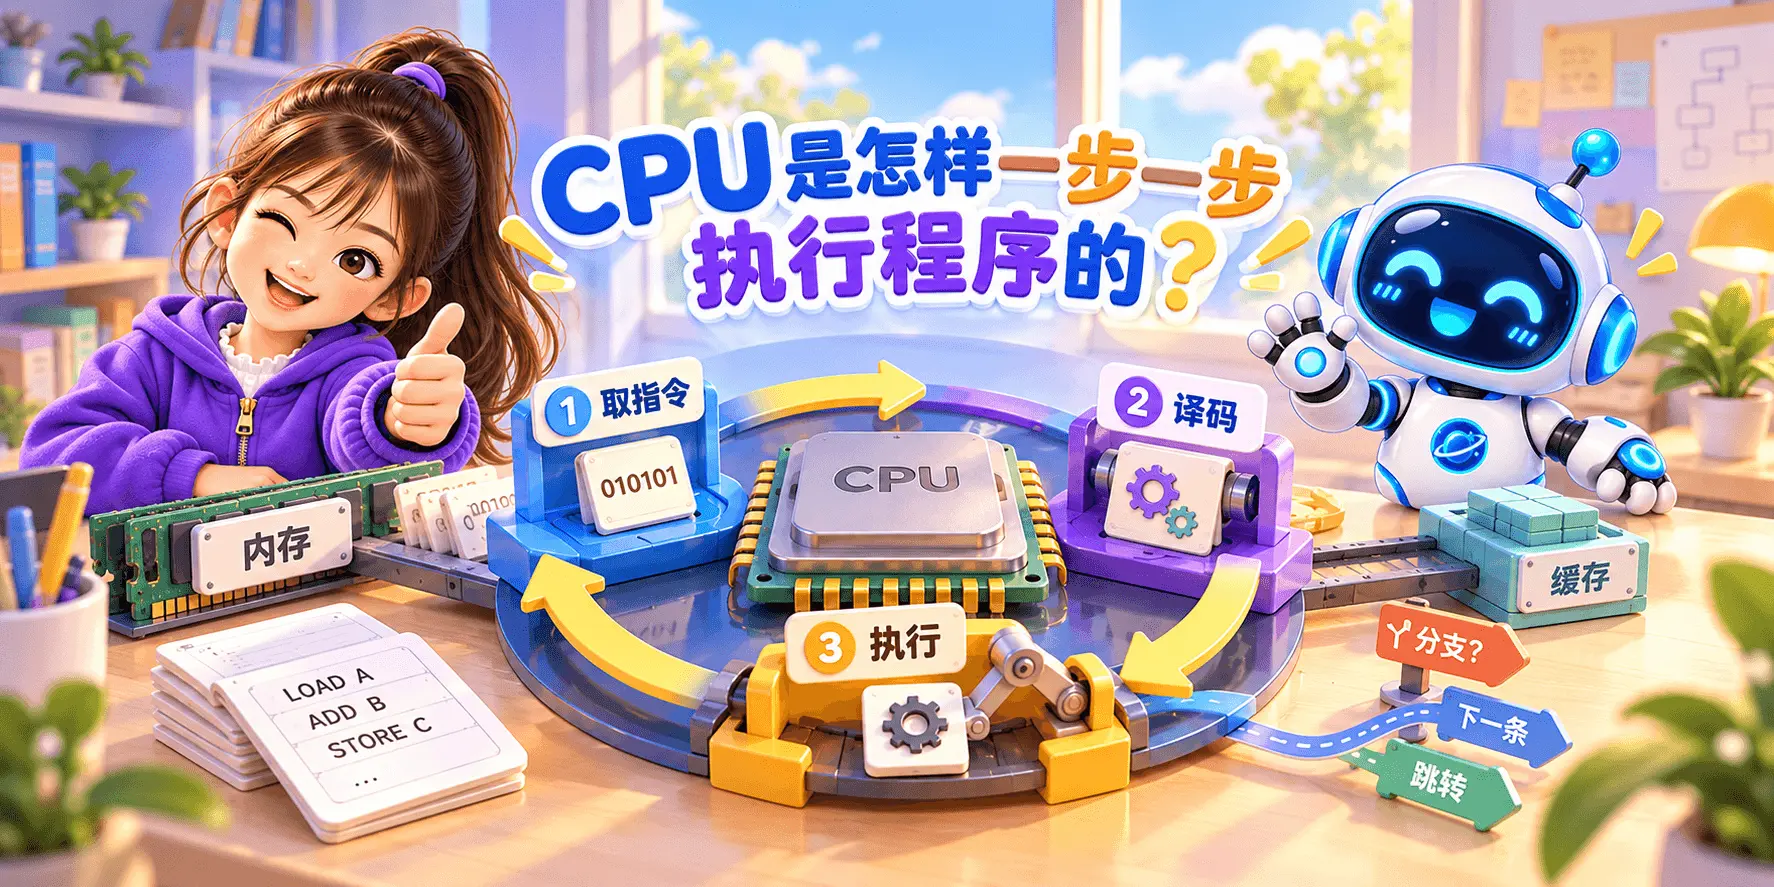
入门时,我们常用 取指(Fetch)→ 译码(Decode)→ 执行(Execute) 来理解 CPU 的基本工作循环。
取指 Fetch
根据指令地址取得要执行的机器指令
译码 Decode
判断这条指令要做什么、需要哪些操作数
执行 Execute
由对应执行单元完成计算、访问数据或跳转等操作
写回 / 完成结果
把需要保留的结果写入寄存器或内存等位置
04寄存器和缓存为什么重要?
CPU 的速度远高于主内存。 如果每做一次小计算都要直接等待 RAM,就会浪费很多时间。
所以 CPU 内部和附近会使用更快的存储层次: 寄存器 → CPU 缓存 → RAM → SSD / 硬盘。
寄存器
直接位于处理器内部,保存当前计算最常用的小量数据
CPU 缓存
保存近期常用的指令和数据
RAM
容量更大,速度比缓存慢
SSD / 硬盘
长期保存,容量大,但延迟更高
05遇到 if 和循环时会发生什么?
程序并不是永远从上到下一条直线走到底。
if、for、while、函数调用等,
最终都会让 CPU 遇到跳转或分支相关的机器指令。
比较条件
例如:x 是否大于 10?
循环的本质之一,就是让程序在满足某些条件时, 跳回前面的某个指令位置继续执行。
06现代 CPU 真的是一条一条慢慢做吗?
如果只看入门模型,很容易以为 CPU 完整做完一条指令后, 才开始下一条。 现代高性能 CPU 通常不是这么简单。
流水线
不同指令可以同时处在取指、译码、执行等不同阶段
乱序执行
在不破坏程序可观察结果的前提下,处理器可以先做已经准备好的工作
分支预测
提前猜测程序可能走哪条分支,减少等待
超标量执行
某些 CPU 每个时钟周期可以发射或完成多条独立操作
07用一个小例子串起来
假设程序要完成: 先计算 3 + 5,如果结果大于 6,就把结果保存下来。
result = 3 + 5;
if (result > 6) { save(result); }
取得相关机器指令
PC 指向下一条要处理的指令
取到数据 3 和 5
可能来自寄存器、缓存或更低层存储
执行加法
得到结果 8
比较 8 和 6
得到“8 大于 6”的条件结果
改变执行路线
进入保存结果的那部分代码
你已经知道了什么
- CPU 最终执行的是机器指令,而不是直接执行 C++ 源代码。
- 程序计数器等机制帮助处理器确定接下来从哪里取得指令。
- “取指 → 译码 → 执行”是理解 CPU 工作的经典入门模型。
- 执行过程中,CPU 会大量使用寄存器和缓存,而不是每次都直接访问 RAM。
- if、循环和函数调用最终都会影响程序接下来执行哪一段机器指令。
- CPU 不会“思考”,它只是按照指令和数据改变自己的状态并产生结果。
- 现代 CPU 会使用流水线、乱序执行、分支预测和超标量等技术提高效率。
- 真实 CPU 的内部实现比教学模型复杂,不同处理器架构也会有所不同。
下一个问题: 如果 CPU 同一时间只有有限的核心, 为什么我们却可以一边听音乐、一边浏览网页、还开着聊天软件? 下一篇:为什么电脑可以同时运行很多程序?